第 01 章:Agent Loop —— 模型定下一步,程序负责执行
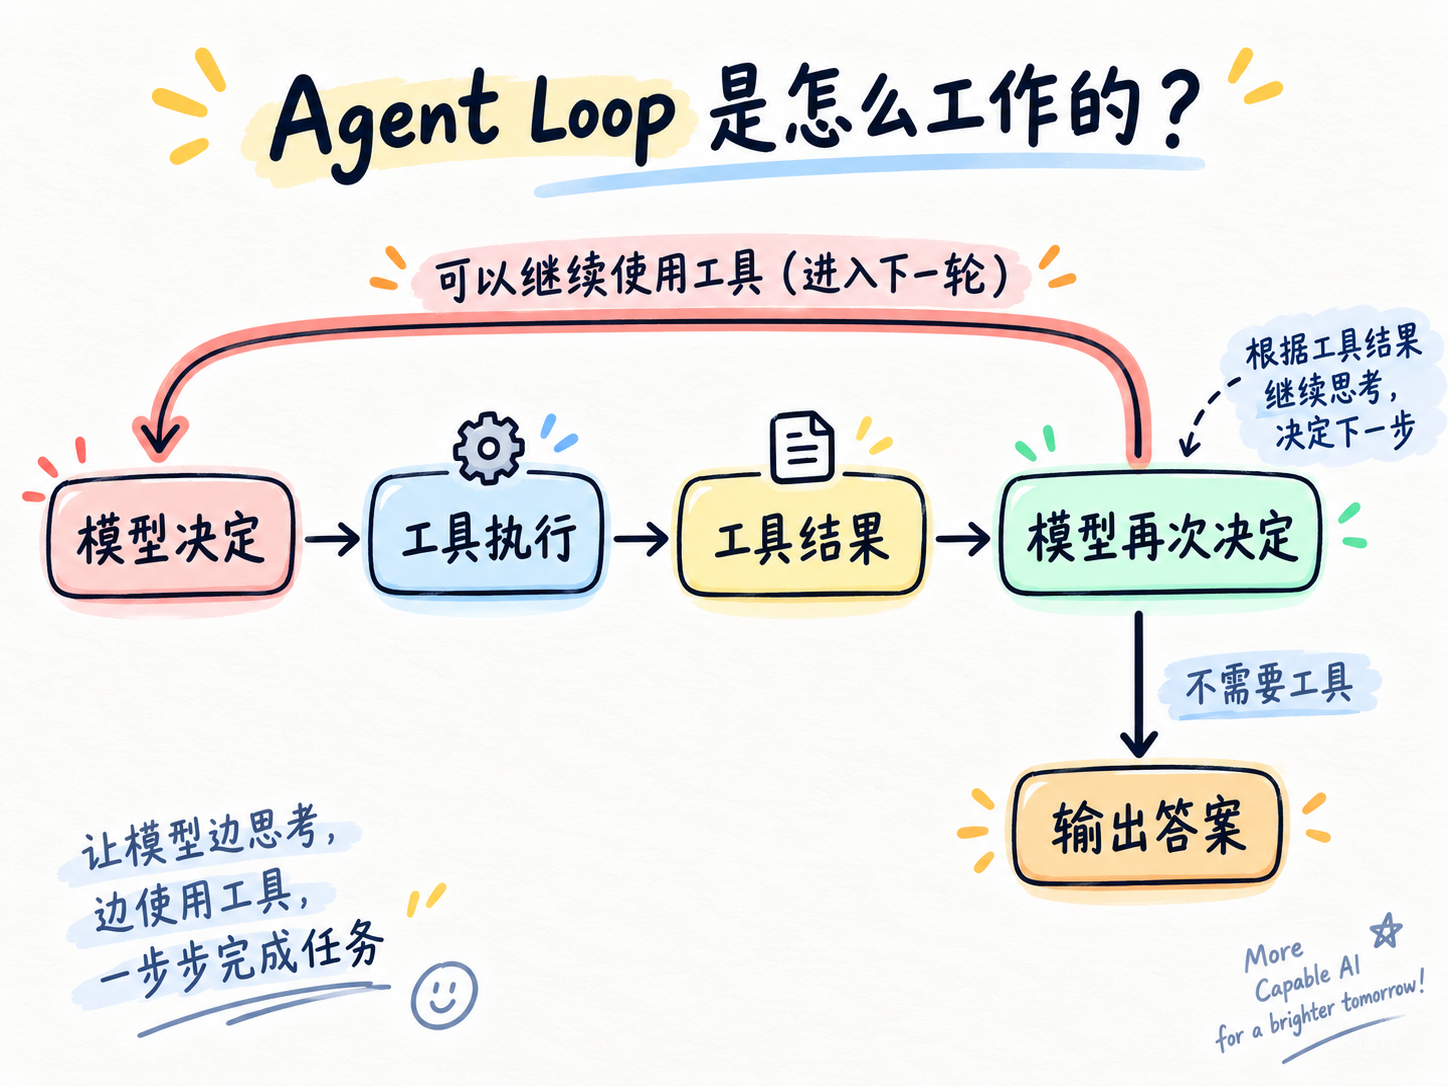
一句话总结:Agent Loop 是一个抽象:程序反复把当前状态交给模型,模型决定下一步,程序执行并记下结果,直到满足停止条件。ReAct、Plan-and-Execute、Reflection 是它的不同实现方式。
先看图
图里的循环由应用程序(Harness,负责提供工具并控制执行的代码)驱动:
- 应用把用户任务和可用工具一起发给模型。
- 模型返回
tool_calls时,它是在提出调用请求;工具还没有运行。 - 应用检查请求并执行工具,把结果作为
role="tool"消息带上对应的tool_call_id。 - 应用把更新后的消息再次发给模型。模型可以继续请求工具,也可以返回文字。
- 模型不再请求工具时,走出口:把文字交给用户,循环结束。
模型本身不会执行你的 Python 函数。它只负责“决定下一步”,执行和回传都是应用的事。
Agent Loop 是一个抽象
先抛开具体接口,Agent Loop 的骨架只有这么几行(伪代码):
def agent_loop(task):
    state = [task]
    for _ in range(MAX_TURNS):              # stop: turn limit
        step = decide(state)                # the model picks the next step
        if step.is_final:                   # the model thinks it is done
            if goal_achieved(state):        # stop: goal verified by the program
                return step.answer
            state.append("not done yet")    # push back and keep working
            continue
        result = execute(step)              # the harness runs the step
        state.append((step, result))        # the result goes back into the state
    return "turn limit reached"
骨架里有四个位置,每种实现都要给出自己的回答:
| 问题 | 本章代码的回答 |
|---|---|
| 状态放在哪? | 一份 messages 列表,每轮追加 |
| 下一步谁来定? | 模型,每轮决定调哪个工具或直接回答 |
| 执行结果什么时候回到模型? | 每执行一步就回传 |
| 什么时候停? | 模型不再调用工具,或到达 MAX_TURNS;还没有检查目标是否达成 |
只要“下一步由模型决定、结果回到模型”,就是 Agent Loop。至于每步想多远、要不要先列计划、要不要自查,是不同实现的区别。
第一个实现:ReAct
本章代码用的是 ReAct(Reasoning + Acting,推理加行动),出自 2022 年的同名论文。它是最常见、也最适合入门的实现:想一步、做一步、看结果,再想下一步。
只推理不行动,模型记错了也只能接着编;只行动不推理,又容易跑偏。ReAct 让两者交替,每个动作的结果都会回到模型,影响下一步。
论文里,模型输出的是纯文本,程序从文本里解析出动作:
Question: Python 3 是哪年发布的?
Thought 1: 我需要查 Python 3 的发布时间。
Action 1: Search[Python 3]
Observation 1: Python 3.0 于 2008 年 12 月发布……
Thought 2: 找到了,可以回答。
Action 2: Finish[2008 年]
现在的模型接口原生支持工具调用,Action 改成了结构化的 tool_calls,不用再从文本里解析。tool_calls 只是 Action 的写法,思想没变:
| ReAct 概念 | 本章代码里的对应物 |
|---|---|
| Thought:想下一步 | 模型内部的推理,或 assistant 消息里附带的文字 |
| Action:做一步 | assistant 消息里的 tool_calls |
| Observation:看结果 | 应用追加的 role="tool" 消息 |
| Finish:给出答案 | 没有 tool_calls、finish_reason 为 stop 的回复 |
用生活例子理解
你让助理“查一下今天是几号”。
- 助理先想:“我得看看日历。”(Thought)
- 然后拿起手机看一眼。(Action)
- 看到日期。(Observation)
- 觉得够了,直接告诉你。(Finish)
这是 ReAct 式的助理:走一步看一步。换一个助理,也可以先列好计划再做,或者交差前自己复查一遍。做法不同,但都是“自己决定下一步、看结果、再决定”的循环。
用 DeepSeek 跑起来
本章的完整示例在 code.py,把上面的骨架落成 ReAct 式循环,只注册了一个无副作用的日期查询工具。先准备密钥并运行:
uv sync
cp .env.example .env
在 .env 中填写 DEEPSEEK_API_KEY,然后执行:
uv run python chapters/01-agent-loop/code.py控制流的关键部分是:
for _ in range(MAX_TURNS):
    response = client.chat.completions.create(
        model=MODEL,
        messages=messages,
        tools=TOOLS,
        tool_choice="auto",
    )
    choice = response.choices[0]
    message = choice.message
    # Thought + Action: the model's reply, possibly with tool_calls
    messages.append(message.model_dump(exclude_none=True))

    # Finish: no tool call means the model is ready to answer
    if not message.tool_calls:
        if choice.finish_reason != "stop":
            return f"模型未正常结束:{choice.finish_reason}"
        return message.content or ""

    if choice.finish_reason != "tool_calls":
        return f"工具调用未正常结束:{choice.finish_reason}"

    # Observation: run each tool and feed the result back
    for call in message.tool_calls:
        result = run_tool(call)
        messages.append({
            "role": "tool",
            "tool_call_id": call.id,
            "content": result,
})问“今天是几号?”时,messages 会这样一步步变长:
system:    你是一个简洁的中文助手……
user:      今天是几号?
assistant: tool_calls=[get_today()]          ← Action
tool:      2026-10-08                        ← Observation
assistant: 今天是 2026 年 10 月 8 日。        ← Finish
messages 就是循环的状态。模型每一轮都能看到之前做过什么、看到了什么,所以能接着判断。示例按返回顺序逐个执行调用;如果改成并行,先确认这些工具互不依赖,并且并发执行不会带来副作用问题。
什么时候停
Agent Loop 有三种停止条件,含义完全不同:
| 停止条件 | 谁说了算 | 能说明什么 |
|---|---|---|
| 模型认为完成:不再调用工具 | 模型 | 模型这一轮想交差了 |
达到上限:MAX_TURNS | 程序 | 循环被截停,任务大概率没做完 |
| 目标达成(Goal achieved):验收通过 | 程序按证据判断 | 任务真的完成了 |
本章代码只实现了前两种。模型说“完成了”不等于真的完成:工具返回了错误,模型仍可能生成“已完成”。要判断目标达成,得看可信证据,例如文件差异、测试退出码或数据库状态。把这一步加进循环,就是第 17 章 Goal Loop 的内容。
finish_reason 也值得检查:DeepSeek 文档列出的结束原因包括 length、content_filter、insufficient_system_resource 和 aborted。本例只有在没有工具调用且原因为 stop 时才返回模型文字;有工具调用时也只有原因为 tool_calls 才执行。其他状态都交给调用方,避免执行可能被截断的参数。生产应用还需对 API 超时、无效工具参数和工具执行失败分别定义恢复策略。
每次继续循环都会再请求一次模型并带上消息历史,会增加延迟和 token 成本。直接回答就足够的任务不必调用工具;工具调用只是模型可选的下一步。
扩展阅读:其他实现,以及相邻的概念
Agent Loop 的其他实现
- Plan-and-Execute:先让模型列出计划,再按计划执行,根据结果调整计划。适合步骤多、容易漏的任务。见第 05 章 Planning。
- Reflection:模型交差前先自查,不满意就带着问题重做。适合一次难做对的任务。
它们和 ReAct 一样,下一步都由模型决定,只是想得更远或多查一遍。能组合使用,不是非此即彼。
Workflow 不是 Agent
Workflow(工作流)里,下一步由代码决定:先做什么、哪些并行、何时汇总,都提前写死;模型只负责其中需要理解内容的步骤。它不是 Agent Loop 的又一种实现,而是用代码约束和编排模型的工程方式,换来稳定和可复现。真实系统常常两者混用,见第 16 章 Workflow Runtime。
多个 Agent
一个 Agent 的上下文装不下时,可以把子任务交给另一个 Agent Loop 去做,只拿回结果。这是第 06 章 Subagents 的内容。
怎么选:先用 ReAct。容易漏步骤再加计划,质量不稳再加自查,流程固定就写成 Workflow,上下文装不下再拆给子 Agent。
今天只记住
Agent Loop 是“模型决定、程序执行、结果回传、按条件停止”的抽象;ReAct 是它最常见的实现,而“模型说完成了”不等于“目标达成了”。
想一想
第 16 章的 Workflow 也会反复调用模型,为什么本章说它不是 Agent?
参考思路
关键看“下一步谁来定”。Agent Loop 里由模型决定,所以能应对计划外的情况;Workflow 里由代码决定,模型只完成指定步骤,所以更稳定、可复现,但不会变通。实践中常把两者组合:固定的部分写进代码,需要判断的部分交给 Agent。